1
3.1. Classification appliquée aux données textuelles
45
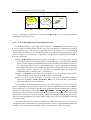
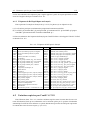
Cercle
Cercle
Cercle
Petit
Petit
d
Petit
Marge
(a)
(b)
(c)
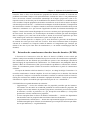
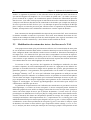
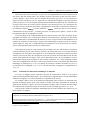
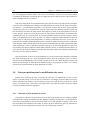
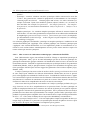
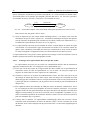
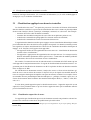
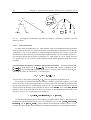
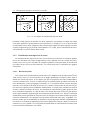
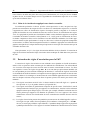
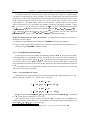
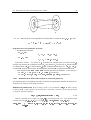
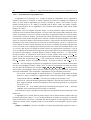
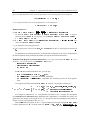
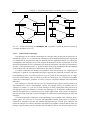
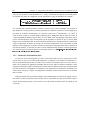
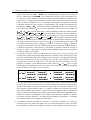
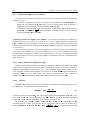
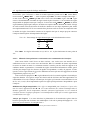
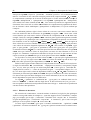
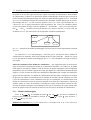
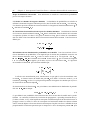
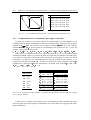
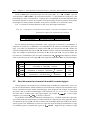
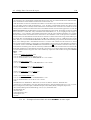
F IG . 3.2 – Exemples de classifications par une SVM.
[Joachims, 1998] propose de chercher une droite séparatrice et de prendre en compte une marge
sur la droite séparatrice qui minimise les textes mal classés (cf. la figure (3.2-c)). Un nouveau texte
est classé dans une des deux catégories selon sa situation par rapport à la droite séparatrice trouvée
en phase d’apprentissage par la SVM. Selon [Dumais et al., 1998], pour la classification de textes,
cette méthode s’est avérée efficace dans son cas.
3.1.2
Classification non supervisée de textes
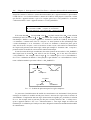
La classification non supervisée de textes est caractérisée par l’absence de catégories prédéfinies et de l’utilisation d’un corpus d’apprentissage. Nous calculons sur tout le corpus une classification sans savoir a priori le nombre de catégories produites. Nous présentons la classification
non supervisée de textes par deux méthodes : les réseaux bayésiens et l’utilisation des graphes
conceptuels.
3.1.2.1
Réseaux bayésiens
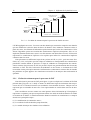
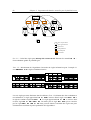
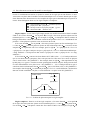
Une variante de la classification bayésienne naïve est la définition d’un réseau bayésien [Pearl,
1988; Jensen, 1996]. Un réseau bayésien est un graphe probabiliste acyclique orienté. Dans le
modèle des réseaux bayésiens, on ne suppose pas que les propriétés sont toutes indépendantes,
certaines sont donc liées. Un texte est représenté par un réseau bayésien qui reflète la structure du
texte (introduction, section, paragraphe, conclusion, etc.). Un nœud du réseau est donc une partie
d’un texte. La transition d’un nœud du réseau vers ses nœuds voisins montre le lien entre les parties d’un texte exprimée par une probabilité conditionnelle. Le corpus entier constitue une forêt de
réseaux et reflète la structure du corpus. Un mécanisme d’unification de graphes permet de faire
de la recherche documentaire. Il s’agit de trouver les réseaux bayésiens (textes) les plus proches
d’une requête modélisée également par un réseau bayésien [Piwowarski et al., 2002]. La technique
d’unification permet également de classer des textes en catégories, de la même manière que pour la
recherche documentaire, en s’appuyant sur la proximité structurelle entre textes. Cependant, l’expérience montre que la classification en utilisant les réseaux bayésiens alourdit considérablement
les calculs et les résultats n’augmentent pas de façon significative [Denoue, 2000]. Le moteur de
recherche I NQUERY [Callan et al., 1992] utilise la classification en construisant un réseau bayésien
pour la recherche documentaire sur le Web.