1
Datenbanken
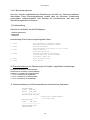
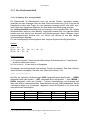
2.1.3.1 Die Normalisierung als Zerlegungsprozeß
1) Problemstellung
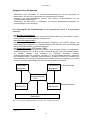
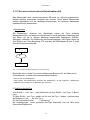
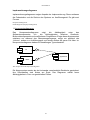
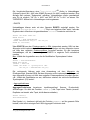
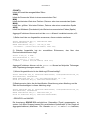
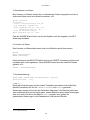
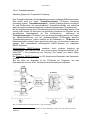
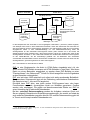
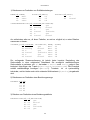
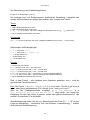
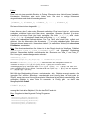
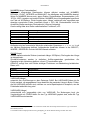
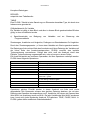
Fallbeispiel: Gesucht ist ein Datenmodell für eine relationale Datenbank, das die
Entitätstypen PERSON (Mitarbeiter), ABTEILUNG, PRODUKT berücksichtigt.
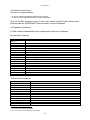
Eine Analyse führt zu folgenden Fakten:
1.
2.
3.
4.
5.
Fakt
Fakt
Fakt
Fakt
Fakt
6. Fakt
7. Fakt
8. Fakt
9. Fakt
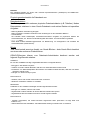
Ein Mitarbeiter hat einen Namen und
einen Wohnort. Er ist
in einer Abteilung tätig und arbeitet an
mehreren Produkten jeweils
eine vorbestimmte Zeit.
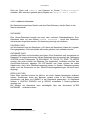
Jede Abteilung hat
einen Namen.
Jedem Produkt ist
ein Name zugeordnet. In einer Abteilung sind
mehrere Personen tätig. An einem Produkt
arbeiten in der
Regel mehrere Personen.
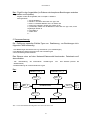
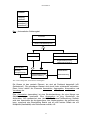
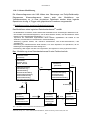
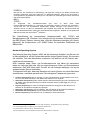
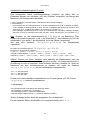
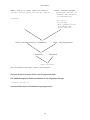
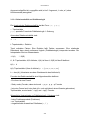
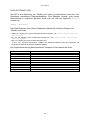
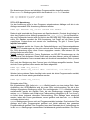
Erkennbar sind:
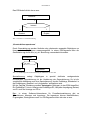
- Entitäten (PERSON, ABTEILUNG, PRODUKT)
- Beziehungen zwischen Entitäten (vgl. 3.,4.,8.,9. Fakt)
- Entitätsattribute (vgl. 1.,2.,6.,7. Fakt)
- ein Beziehungsattribut (vgl. 5 Fakt)
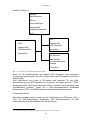
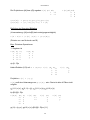
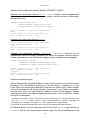
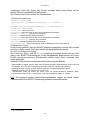
2) Nichtnormalisierte Relation
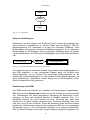
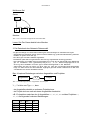
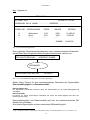
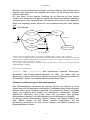
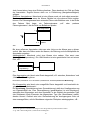
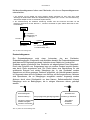
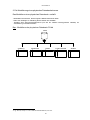
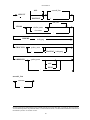
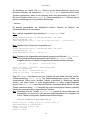
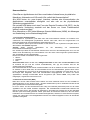
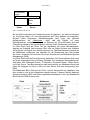
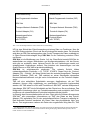
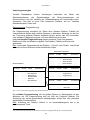
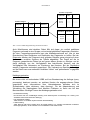
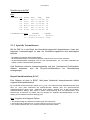
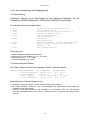
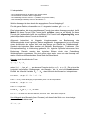
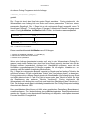
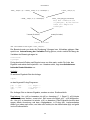
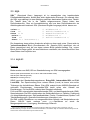
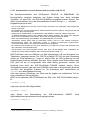
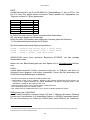
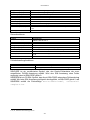
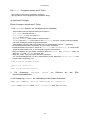
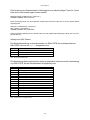
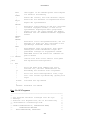
Die Fakten lassen sich alle in der folgenden Tabelle zusammen fassen:
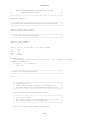
PERSON_UN(PE#,NAME,WOHNORT, A#,
101 Hans Regensburg 1
102 Rolf Nürnberg
2
103 Udo München
2
104 Paul Regensburg 1
A-NAME,PR#,
PR-NAME, ZEIT)
Physik 11,12
A,B
60,40
Chemie 13
C
100
Chemie 11,12,13 A,B,C 20,50,30
Physik 11,13
A,C
80,20
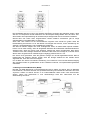
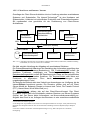
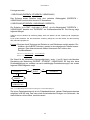
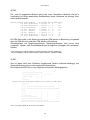
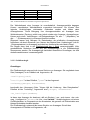
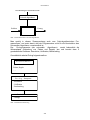
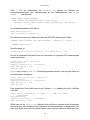
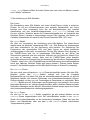
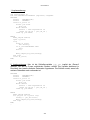
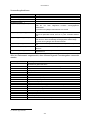
Nachteile dieser Zusammenfassung sind:
1. Die Anzahl der Elemente variiert von Zeile zu Zeile (schwierige Handhabung)
2. Mit nichtnormalisierten Relationen gibt es Schwierigkeiten bei Speicheropera-tionen (Verletzung
realitätskonformer Sachverhalte)
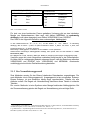
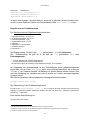
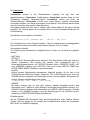
3. Komplexe Verifikations-Programme sind erforderlich, die sicherstellen, daß ein und dasselbe,
redundant auftretende Faktum auch nach der Speicheroperation durchgehend den gleichen Wert
aufweist.
166